动机
显示一个标签很简单,把图像处理、模型和界面连起来才是工程任务。
01 / 项目速览
显示一个标签很简单,把图像处理、模型和界面连起来才是工程任务。
预训练模型能否分类表情?更多数据能否改善不同测试集的表现?
微调 Swin Tiny,对比两个训练阶段,再将 Python 推理接入 Java 网页应用。
按数据集查看准确率和混淆矩阵,避免总体分数掩盖局部退步。
数据处理、训练管理、评估与系统集成,而不是创造新的 Transformer。
让模型跑起来是起点,理解模型为何出错是下一步。
02 / 跟随图像的处理过程
无需上传人脸,也能理解基本流程。
单张拍摄图像经缩放后,转换成三通道灰度张量。
模型把输入分成小块,以局部注意力关联相邻图像区域。
通过移位窗口和多层结构,逐步形成包含更多上下文的特征。
最后一层输出七个分数,原型系统返回分数最高的标签。
此示意图用于解释结构,不识别情绪、不产生真实预测,也不请求摄像头权限。
03 / 论文报告的证据
相同结构,比较继续训练前后的表现。
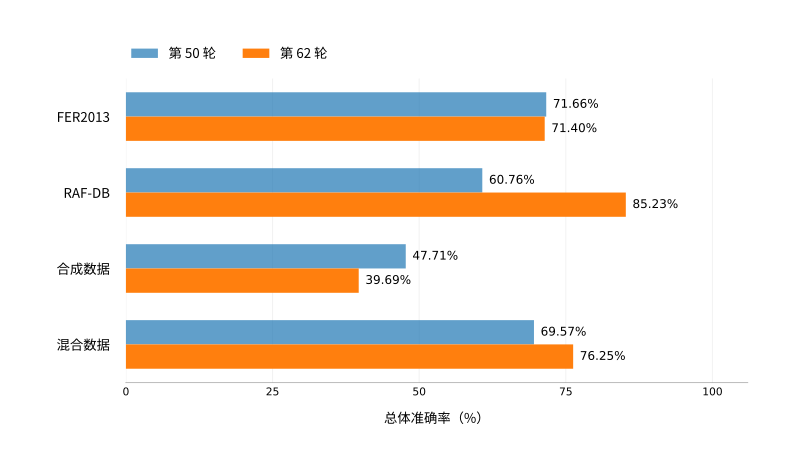
RAF-DB 改善,FER2013 几乎不变,合成数据集表现下降。混合测试结果不代表现实部署准确率。
RAF-DB 参与了第二阶段训练,因此这不能证明对全新数据来源的泛化能力。
| 测试集 | 第 50 轮 | 第 62 轮 | 变化(百分点) |
|---|---|---|---|
| FER2013 | 71.66% | 71.40% | -0.26 |
| RAF-DB | 60.76% | 85.23% | +24.47 |
| Synthetic | 47.71% | 39.69% | -8.02 |
| Mixed | 69.57% | 76.25% | +6.68 |
混合测试集由前三种来源组成,并非第四个独立人群。训练时长与数据构成同时改变,这些观察不能分离合成数据的独立作用。
04 / 技术深读
这是应用开发与评估项目。我使用已有预训练模型,而不是设计新的注意力机制。
准备输入、配置训练、分析错误,并把模型连接到网页界面。
Swin Transformer 与 timm 提供网络实现,PyTorch 提供自动求导和参数优化。
FER2013 和 RAF-DB 提供基准图像,SDXL 脚本生成辅助合成图像。分类器使用愤怒、厌恶、恐惧、开心、中性、悲伤和惊讶七个标签。
对转换到 [0, 1] 的普通 8 位图像,该操作映射到 [−1, 1];测试与推理不使用随机增强。
合成提示词组合光照、姿态、背景、遮挡和表情强度。归档生成器使用 SDXL Base 1.0、FP16、guidance 9.5、50 步,每个激活类别目标为 200 张。保存版本仅激活了 disgust,不能据此复原全部历史生成过程。
timm 模型标识为 swin_tiny_patch4_window7_224。预训练权重适配七类输出,未自行实现 Swin 内部模块。
56 × 56 × 96 · 2 blocks
28 × 28 × 192 · 2 blocks
14 × 14 × 384 · 6 blocks
7 × 7 × 768 · 2 blocks
224 × 224 输入分成 4 × 4 图像块。窗口注意力处理局部区域,移位窗口实现跨窗口信息交换。
z 是原始类别分数。Softmax 解释概率映射,但原型仅取最大 logit 对应的标签,并未评估置信度校准。
现在我会纠正原报告中的理论表述:全局自注意力随 token 数量呈二次 O(N²) 增长,而不是指数增长。
FER2013 → 第一阶段权重
FER2013 + RAF-DB + 合成图像 → 第 62 轮
| 配置项 | 归档值 |
|---|---|
| 批大小 | 128 |
| 初始学习率 | 0.0001 |
| 优化器 | AdamW;传入全部模型参数 |
| 损失函数 | 交叉熵;标签平滑 0.1 |
| 学习率调度 | CosineAnnealingLR |
交叉熵衡量预测与目标分布的差异。标签平滑使目标分布不那么极端,但不能证明不确定性可靠。
论文描述 50 + 12 轮;保存的训练脚本则是后来设置的 100 轮配置并加载已有权重。我不把该快照视为原始实验日志,也不依据打包后变化的路径推断实验错误。
总体准确率回答“多少标签预测正确”;类别准确率与混淆矩阵揭示具体混淆。归档代码不能支持已经完成 Macro-F1、置信度校准或独立鲁棒性测试的说法。
最终测试不应指导检查点或超参数选择。历史分区需要记录核验,而不是猜测文件夹名称。
第二阶段同时改变训练轮数与数据来源。缺少对照时,无法分离各因素的独立作用。
原型是拍照提交式网页应用,不是连续逐帧情绪识别。当前作品集不运行该分类器。
| 模块 / 函数 | 作用 |
|---|---|
| openCamera() / captureImage() | 浏览器摄像头权限与画布截图 |
| submitImage() | 使用 FormData 和 fetch 上传 PNG |
| doPost() | 接收上传、生成临时文件、返回 JSON |
| runPythonScript() | 通过 ProcessBuilder 启动 Python 并读取输出 |
| predict_image() | 预处理 → 权重推理 → 最高分类别 |
| finally / deleteIfExists() | 尝试清理临时图像 |
界面包括首页、识别、介绍、联系和隐私页。客户端使用 HTML、CSS、JavaScript 和 Bootstrap;Java Servlet / Tomcat 调用 Python。训练使用云端 GPU,网页演示使用本地服务与 HTTPS 隧道;不宣称完成生产负载测试或全面安全审计。
| 阶段 | 检查内容 | 证据边界 |
|---|---|---|
| 功能 | 摄像头、上传、推理与返回 | 依据报告和代码;未重新执行原系统 |
| 兼容性 | 电脑和手机界面 | 报告中的人工测试 |
| 隐私 | HTTPS 与临时文件清理 | 基础措施;并非合规认证 |
| 性能 | 响应时间设计目标 | 缺少完整基准日志 |
05 / 批判性反思
我学会了连接完整的机器学习应用。回头看,我会更重视理解错误与测试替代方案,而不仅仅是让流程运行。
可运行流程不等于公平比较。
加入条件一致的 ResNet 基线和受控消融。
类别不平衡与域差异会掩盖错误。
报告 Macro-F1、类别错误与独立分布变化测试。
提示词不等于核实过的标签。
审核标签,分离来源和训练时长的影响。
代码快照不能复原每次实验。
记录分区、种子、环境和每次实验配置。
这些是现在的反思与拟议改进,不表示额外实验已经完成。
对照 2025 年本科报告(尤其第 5–6 章)及所提供的模型、训练、推理、数据和网页代码核验;未重新训练复现实验数值,并区分归档配置与报告中的实验。
政策核查日期:2026 年 11 月 4 日。已完成评估的学生作品能否分享,仍取决于权利归属、合作、课程、第三方及数据条件;一般政策并不构成项目专属许可。本站不分发论文 PDF、原始研究源码、模型权重或患者图像。
示意图为原创几何图形,不重建患者图像,也不代表新的模型实验。